

Yıllardır kullandığımız bilgisayarların temel çalışma mantığı oldukça nettir:
İnsan kuralları yazar, bilgisayar bu kuralları uygular.
Bir yazılımın ne yapacağı geliştirici tarafından önceden tanımlanır. Belirli bir koşul gerçekleştiğinde hangi işlemin yapılacağı kod içerisinde açıkça belirtilir.
Bu yaklaşım, kuralların önceden tanımlanabildiği problemler için son derece etkilidir.
Ancak her problem bu kadar düzenli değildir.
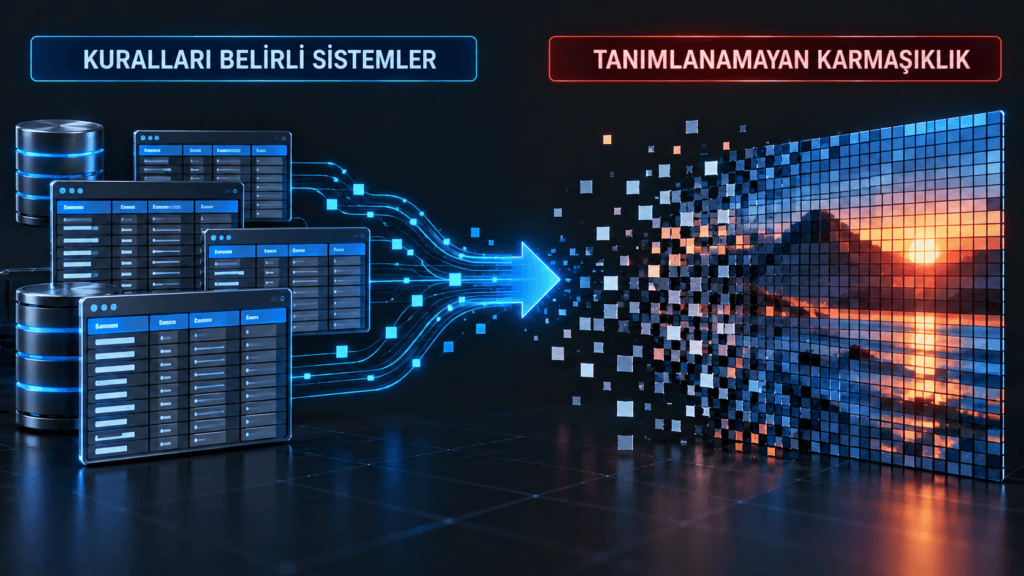
Bir bilgisayara fotoğraftaki kediyi tanımayı öğretmek istediğimizi düşünelim. Bir kediyi tanımlamak için milyonlarca pikselin oluşturabileceği bütün olası durumları tek tek if koşullarına dönüştürmek pratik olarak mümkün değildir.
İşte makine öğrenmesine giden yol tam olarak bu noktadaki problemden doğdu:
Kuralları tek tek yazmak yerine, bilgisayarın verilerden örüntüyü öğrenmesini sağlayabilir miyiz?
Kural Yazmanın Yetmediği Nokta
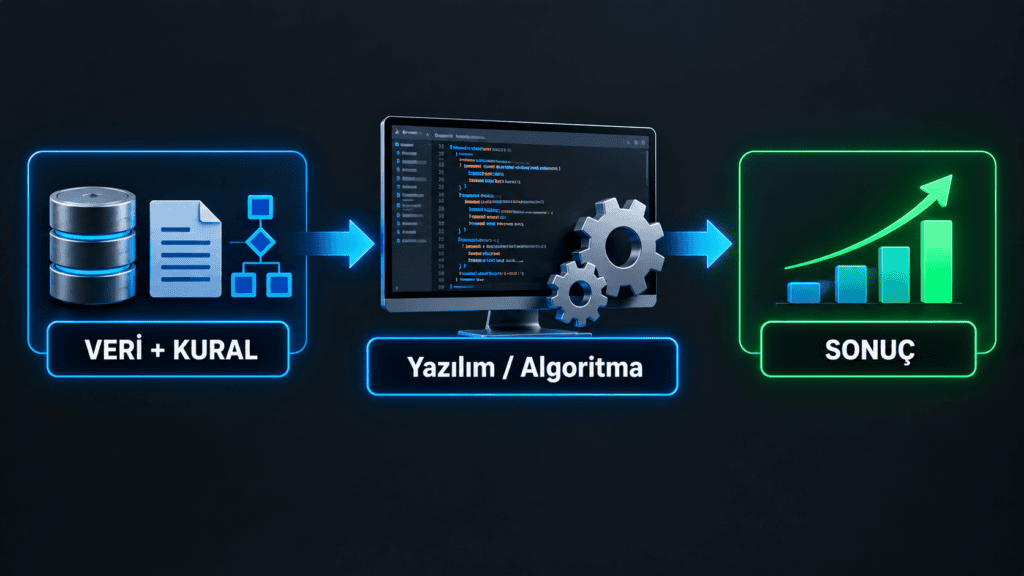
Geleneksel yazılım yaklaşımında akış oldukça nettir:
Girdi → Kurallar → Sonuç
Programcı, problemin nasıl çözüleceğini bilir ve bu çözümü bilgisayara adım adım tarif eder.
Fakat bazı problemlerde sonuç için gerekli kuralları açıkça tanımlamak son derece zordur.
Örneğin görüntü tanıma bunun klasik örneklerinden biridir.
Bir görüntünün içerisinde bir kedi olduğunu anlamak için yalnızca birkaç basit özellik yeterli değildir. Görüntünün ışığı değişebilir, kamera açısı değişebilir, kedi farklı bir pozisyonda olabilir veya görüntünün bir bölümü başka bir nesne tarafından kapatılabilir.
Bu değişkenlerin tamamını önceden yazılmış katı kurallarla tanımlamak kısa sürede devasa ve kırılgan bir kural sistemine dönüşür.
İşte yapay zekâ araştırmalarının erken dönemlerinde önemli yaklaşımlardan biri olan Sembolik Yapay Zekâ, bu tür problemlerde kural tabanlı yöntemlere dayanıyordu.
Sembolik Yapay Zekâ: Bilgiyi Kurallara Dönüştürmek
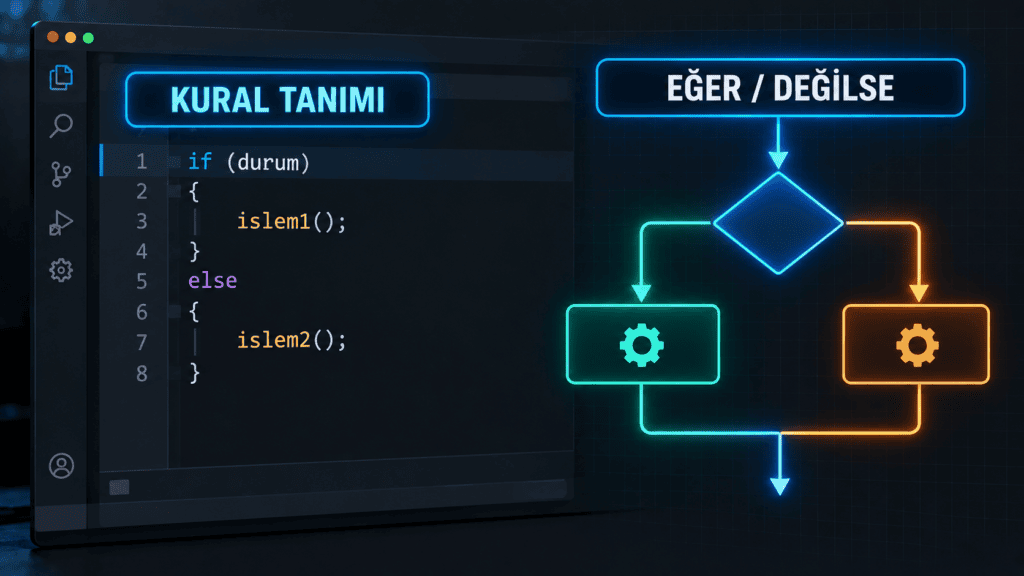
Sembolik yaklaşımda amaç, uzmanlık bilgisini bilgisayarın uygulayabileceği açık kurallara dönüştürmekti.
Bir sistemde ne kadar fazla bilgi varsa, bu bilgiyi kurallar şeklinde ifade etmek ve bilgisayara aktarmak hedefleniyordu.
Fakat gerçek dünya, katı kurallardan oluşmuyordu.
Görüntü değiştiğinde, açı farklılaştığında veya istisnalar arttığında önceden yazılmış kurallar yetersiz kalmaya başladı.
Bir problemi çözmek için daha fazla kural ekledikçe sistem büyüyor, fakat gerçek dünyanın bütün çeşitliliğini yine de kapsamak zorlaşıyordu.
Burada yapay zekâ açısından çok önemli bir fikir değişikliği ortaya çıktı.
Soruyu değiştirmek gerekiyordu.
Bilgisayara:
“Hangi kuralları uygulamalısın?”
demek yerine,
“Bu örneklerden hangi örüntüyü çıkarabilirsin?”
diye sormak mümkün müydü?
Kuralları Yazmak Yerine Veriden Öğrenmek
Makine öğrenmesinin temel fikri bu yaklaşım değişikliğine dayanır.
Artık geliştiricinin bütün kuralları tek tek yazması yerine modele örnekler ve bunların sonuçları verilir.
Model, bu örnekler arasındaki ilişkileri matematiksel olarak temsil etmeye çalışır.
Örneğin denetimli öğrenmede elimizde girdiler ve bunlara karşılık gelen gerçek sonuçlar bulunur.
Model bir tahmin üretir.
Ardından bu tahmin gerçek sonuçla karşılaştırılır.
İki sonuç arasındaki fark, yani hata, hesaplanır.
Bu hata modelin parametrelerinin hangi yönde değiştirilmesi gerektiğine ilişkin bilgi sağlar.
Parametreler küçük adımlarla güncellenir ve model yeniden değerlendirilir.
Bu işlem tekrarlandıkça model, eğitim verilerindeki örüntüyü daha iyi temsil etmeye çalışır.
Buradaki amaç yalnızca eğitim örneklerini ezberlemek değildir.
Asıl amaç, modelin daha önce görmediği örneklerde de öğrendiği örüntüyü kullanabilmesidir.
Buna genelleme denir.
Makinenin “Öğrenmesi” Gerçekte Ne Anlama Geliyor?
Burada önemli bir kavramsal ayrım yapmak gerekiyor.
Bir makinenin öğrenmesi, insanın deneyim kazanması veya bilinçli şekilde düşünmesi anlamına gelmez.
Makine öğrenmesi bağlamında “öğrenme”, modelin parametrelerinin eğitim verisinden elde edilen hata sinyaline göre güncellenmesi anlamına gelir.
Süreç kabaca şöyle ilerler:
Veri → Tahmin → Hata → Parametre Güncellemesi → Yeni Tahmin
Model, her güncellemede verilerdeki ilişkileri daha iyi temsil eden parametre değerlerine ulaşmaya çalışır.
Dolayısıyla burada “öğrenme” kelimesinin arkasında matematiksel bir optimizasyon süreci bulunur.
Bu Fikir Nasıl Gelişti?
Makine öğrenmesine ulaşmak tek bir anda gerçekleşmedi.
Farklı dönemlerde farklı yaklaşımlar ortaya çıktı ve her biri bir önceki yöntemin çözemediği problemlere cevap vermeye çalıştı.
Bu gelişim içerisinde Alan Turing’in çalışmaları önemli bir düşünsel zemin oluşturdu.
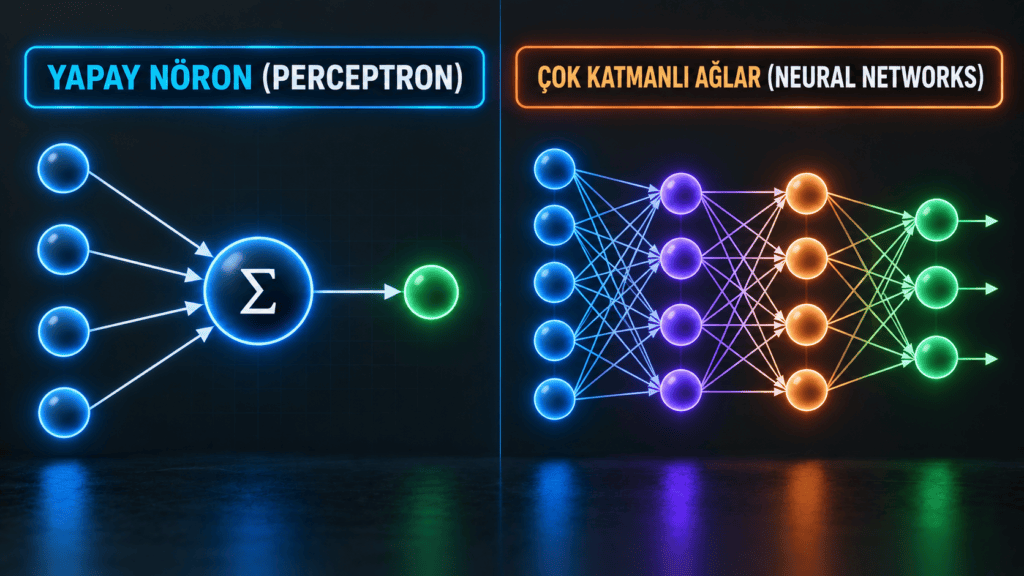
Daha sonra yapay nöron fikrinin somut örneklerinden biri olan Perceptron ortaya çıktı.
Perceptron, daha karmaşık yapay sinir ağı modellerine giden yolda önemli bir adımdı.
Tek bir yapay nöron modelinden başlayan fikir, zaman içerisinde birden fazla katmanın kullanıldığı Yapay Sinir Ağlarına dönüştü.
Böylece modeller daha karmaşık ilişkileri temsil edebilecek yapılara doğru ilerledi.
Yapay Sinir Ağlarından Özel Mimari Yapılara
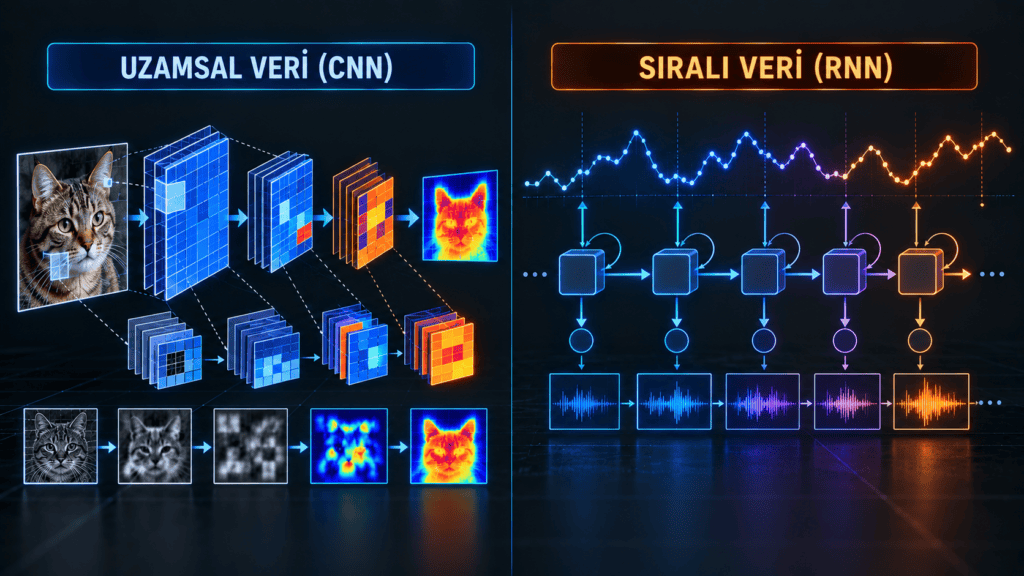
Tek bir model bütün veri türleri için aynı şekilde ideal çalışmaz.
Verinin yapısı değiştikçe, o yapıya uygun mimariler geliştirildi.
Örneğin görüntü gibi uzamsal yapıya sahip veriler için CNN (Convolutional Neural Network) mimarileri geliştirildi.
Sıralı veriler için ise RNN (Recurrent Neural Network) gibi yaklaşımlar kullanıldı.
Metin de sıralı bir veri olarak ele alınabildiği için RNN’ler dil ve metin işleme gibi alanlarda kullanıldı.
Buradaki temel fikir oldukça önemli:
Model mimarisi, çözülmeye çalışılan problemin veri yapısına göre şekillendi.
Fakat yapay zekânın gelişimi burada da durmadı.
RNN’lerin Ötesinde: Attention
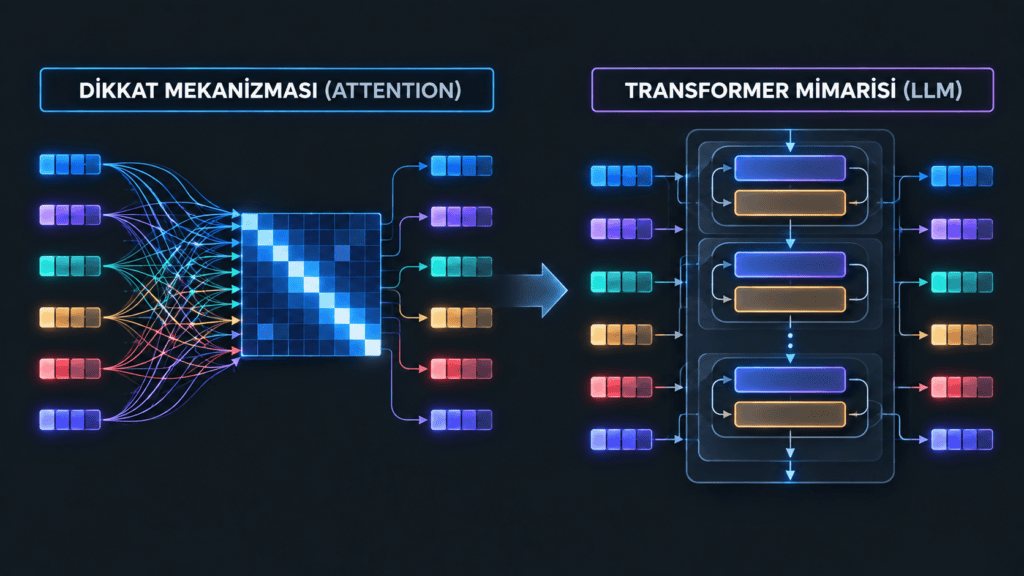
Sıralı verilerle çalışan modellerin karşılaştığı önemli problemlerden biri, uzun diziler içerisinde ilgili bilgilerin birbirleriyle olan ilişkisini etkili biçimde ele almaktı.
Bu noktada Attention mekanizması önemli bir yaklaşım sundu.
Attention, modelin bir dizinin farklı bölümleri arasındaki ilişkileri değerlendirmesine olanak sağladı.
Bu fikir daha sonra Transformer mimarisinin temel bileşenlerinden biri haline geldi.
Transformer mimarisi, bağlam içerisindeki bilgileri daha etkili şekilde işleyebilen bir yapı sundu.
Ve bu gelişmeler, günümüzdeki Büyük Dil Modellerinin (LLM) arkasındaki mimari yaklaşımın kapısını açtı.
Böylece başlangıçta “bilgisayara kuralları nasıl yazdırabiliriz?” şeklindeki problem, zaman içerisinde “bilgisayar verilerdeki örüntüleri nasıl öğrenebilir?” sorusuna dönüştü.
Her Aşama Başka Bir Problemi Çözmeye Çalıştı
Bu gelişim sürecini yalnızca teknoloji isimlerinin arka arkaya gelmesi olarak görmek eksik olur.
Her aşamanın arkasında çözülmeye çalışılan farklı bir problem vardı.
Sembolik Yapay Zekâ, bilgiyi açık kurallarla ifade etmeye çalıştı.
Perceptron, yapay nöron fikrini somutlaştırdı.
Yapay Sinir Ağları, daha karmaşık ilişkileri birden fazla katmanda temsil etmeye yöneldi.
CNN, görüntü gibi uzamsal veriler için özel bir yapı sundu.
RNN, sıralı verilerdeki ilişkileri ele almaya odaklandı.
Attention, dizinin farklı bölümleri arasındaki bağlam ilişkilerini daha etkili değerlendirmeye olanak sağladı.
Transformer ise bu yaklaşımı yeni bir mimari düzeye taşıdı ve Büyük Dil Modellerinin gelişiminin önünü açtı.
Yani bu tarihsel yolculukta her adım, çözülemeyen veya yeterince iyi çözülemeyen bir problemin cevabı olarak ortaya çıktı.
Makine Öğrenmesi Aslında Neyi Değiştirdi?
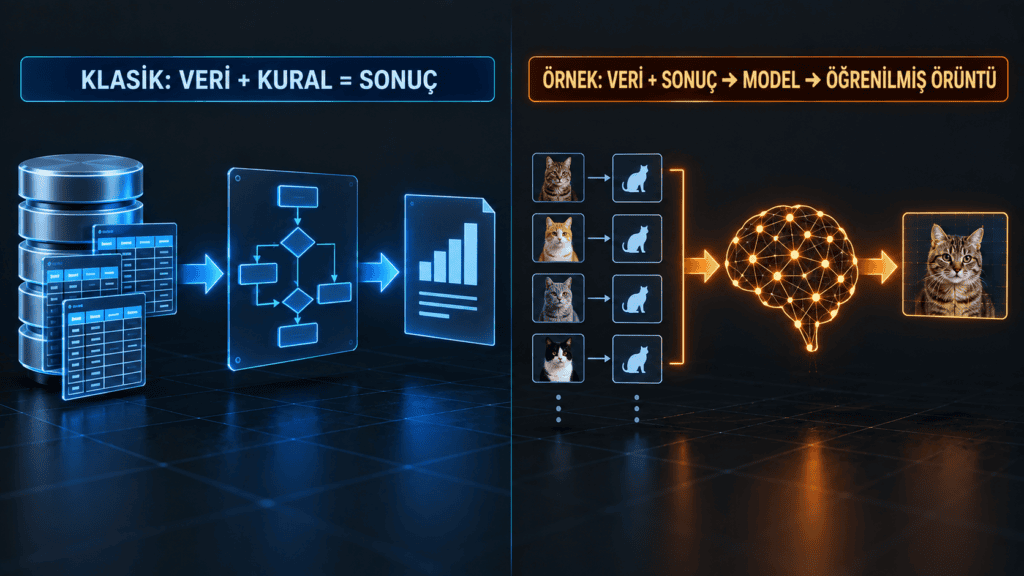
Geleneksel programlamada temel akış:
Kurallar + Veri → Sonuç
şeklinde düşünülebilir.
Makine öğrenmesinde ise yaklaşım farklılaşır:
Veri + Sonuçlar → Öğrenilmiş Model
Model, doğrudan insan tarafından yazılmış bütün kuralları uygulamak yerine verilerdeki örüntüyü matematiksel parametrelerle temsil etmeye çalışır.
Bu nedenle makine öğrenmesi, bilgisayarların “kuralsız” çalışması anlamına gelmez.
Tam tersine, altında yine matematiksel kurallar, algoritmalar ve hesaplamalar bulunur.
Değişen şey, problemin çözümünün bütün ayrıntılarının insan tarafından önceden açıkça yazılmak yerine modelin parametrelerinin veriler üzerinden ayarlanmasıdır.
Sonuç: Kurallardan Örüntülere
Bilgisayarların öğrenmeye başlaması bir anda ortaya çıkan sihirli bir zekâ sıçraması değildi.
Asıl değişim, bazı problemlerin insan tarafından tek tek kurallara dönüştürülemeyecek kadar karmaşık olduğunun anlaşılmasıyla başladı.
Bunun yerine verilerden örüntü çıkaran ve parametrelerini güncelleyen matematiksel modeller kullanılmaya başlandı.
Sonrasında Perceptron’dan yapay sinir ağlarına, CNN ve RNN gibi özel mimarilerden Attention ve Transformer’a uzanan uzun bir gelişim süreci ortaya çıktı.
Bugünkü Büyük Dil Modelleri de bu gelişim zincirinin bir sonraki aşamalarından biri olarak görülebilir.
Dolayısıyla makine öğrenmesinin temel fikrini tek bir cümleyle özetlemek gerekirse:
İnsanların tek tek yazamayacağı kadar karmaşık kuralları doğrudan kodlamak yerine, verilerden örüntü çıkarabilen matematiksel modeller oluşturmak.
Ve belki de bu hikâyenin en önemli tarafı şu:
Bilgisayarların öğrenmeye başlaması, bilgisayarların bir anda insan gibi düşünmeye başlaması değildi.
Bilgisayara problemi çözme kurallarını doğrudan vermek yerine, çözümün arkasındaki örüntüyü veriden çıkarmasını sağlamaya çalışmaktı.
Şimdi Tekrar Bilgisayarın İçine Dönelim
Makine öğrenmesinin nasıl ortaya çıktığını ve kurallardan veriye dayalı modellere geçişin temel mantığını gördük.
Şimdi yeniden bilgisayarın daha düşük seviyedeki katmanlarına dönüyoruz.
Bir sonraki bölümde işletim sisteminin grafik yüklerini yönetirken ekran kartıyla gerçekte nasıl konuştuğunu inceleyeceğiz.
Bir uygulamanın oluşturmak istediği görüntü, Windows’un grafik altyapısından geçerek sürücü ve GPU’ya nasıl ulaşıyor?
Ekranda gördüğümüz tek bir karenin arkasında hangi katmanlar bulunuyor?
Sırada bilgisayarın perde arkasındaki bu grafik iletişim zinciri var.